- 최초 작성일: 2000-10-11
- 최종 수정일: 2026-09-29
- 조회수: 29 회
- 작성자: 권현욱 (엑셀러)
- 강의 제목: 다양한 Counting 방법들
들어가기 전에
오래 전 엑셀 파일로 진행하던 강의를 웹 글로 복원한 것이라, "버튼을 눌러보세요"처럼 엑셀에서 직접 조작하라는 표현이 남아 있을 수 있습니다. 결과는 본문의 그림이나 표로 확인하실 수 있으며, 현재와 맞지 않는 내용은 보완하되 전반적인 스타일은 당시의 갬성(?)을 유지했습니다.
Excel로 작업을 하다보면 특정 영역 내에 있는 자료들에 대해 여러 가지 방법으로 Counting하는 경우가 자주 있습니다. 이번 시간에는 자료를 카운팅하는 여러 가지 방법들에 대해 설명을 드리겠습니다.
먼저 자료 테이블을 하나 만들고…
| 영역1 | 영역2 | 영역3 | 영역4 |
| 1 | 가 | 갑돌이 | 가 |
| 2 | 나 | 을순이 | |
| 3 | 나 | 병동이 | |
| 1 | 다 | 정순이 | 1 |
| 2 | 다 | 갑돌이 | 가 |
| 3 | 다 | 갑순이 | |
| 3 | 라 | 갑돌이 | |
| 3 | 가 | 삼돌이 | |
| 4 | 라 | 마당쇠 | 라 |
| 5 | 라 | 갑순이 | |
| 6 | 마 | 갑순이 | 6 |
| 7 | 마 | 갑순이 | |
| 7 | 가 | 을동이 | 7 |
| 8 | 가 | 을순이 | |
| 9 | 나 | 삼순이 | 나 |
| 5 | 다 | 삼식이 | |
| 3 | 바 | 갑순이 | 바 |
| 1 | 사 | 병순이 | 사 |
| 1 | 가 | 정순이 | |
| 2 | 나 | 기동이 | 1 |
이렇게 자료를 만든 다음, 각 영역별로 이름을 지정해(Naming) 주었습니다. 좌측 상단의 이름상자(Name Box) 옆에 있는 드롭다운 상자를 클릭해 보세요.
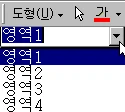
이렇게 4개의 영역에 이름을 정의 하였습니다. 작업을 하기 전에 이름 정의를 하는 것은 아주 좋은 습관이니까 적극 활용하시기 바랍니다.
이름을 어떻게 정의하는지 모르신다구요?(그러면 큰일인데…) "삽입-이름-정의" 메뉴를 사용해서 하셔도 되지만 그것보다는 범위를 지정하신 다음에 위 그림의 이름 상자에 이름을 직접 입력하고 엔터키를 탁 치시면 됩니다.
- 최신 글을 불러오는 중...

다양한 Counting 방법들
핵심 요약
- FREQUENCY 함수와 배열수식을 이용하면 숫자 자료에서 중복을 제외한 고유 항목의 개수를 계산할 수 있습니다.
- 문자열이나 공란이 섞인 자료는 MATCH와 LEN을 함께 사용해 고유 항목을 판별할 수 있습니다.
- INDEX·MATCH·COUNTIF를 조합하면 가장 자주 나타나는 문자열과 그 빈도수도 구할 수 있습니다.
Case 1 숫자 자료들 중에서 중복되지 않는 항목의 개수 세기
"영역 1"과 같은 숫자 자료가 있다고 가정합니다. 자료를 보니 중복되는 숫자값이 눈에 띄는군요. 이 숫자들 중에서 유일한 숫자들의 개수를 Counting하려면 어떻게 해야 할까요?
=SUM(IF(FREQUENCY(영역1,영역1)>0,1))계산을 해보니(직접 세어 보아도 마찬가지!) 9가지가 나오는군요. 다른 것은 아실 것이고… Frequency()라는 새로운 함수가 사용되었습니다. 이 함수는 "사용자가 지정한 범위 내에서 각 값들의 사용빈도를 구한 다음, 배열의 형태로 되돌려 주는 함수" 입니다.
수식편집 모드(<F2>) 상태에서, 위 수식에서 노란색 부분을 범위로 잡은 다음 F9키 를 눌러 보세요. 아래와 같은 배열이 수식입력창 부분에 나타날 것입니다.
참고: 원문에서는 수식의 일부가 노란색으로 강조되어 있었으나 이 페이지에는 강조 표시가 없습니다. 수식 안의 FREQUENCY 또는 MATCH 부분을 직접 선택한 뒤 F9키를 눌러 계산 결과를 확인해 보시기 바랍니다. 확인 후에는 Esc 키를 눌러 수식을 원래대로 되돌리세요.

이게 무슨 소린지 아시겠습니까? 예전에 배열수식에 대해 설명을 드릴 때, 사용했던 방법인데… 위 그림에서 True로 표시된 부분이 유일한 숫자 아이템을 나타냅니다. 잘 연구해 보세요.
Case 2 문자열 자료들 중에서 중복되지 않는 항목의 개수 세기
=SUM(IF(FREQUENCY(MATCH(영역2,영역2,0),MATCH(영역2,영역2,0))>0,1))Case 1과 비슷한데 Match() 함수가 하나 더 사용되었습니다.
Match() 함수에 대해서는 예전에 설명을 드렸지요? 지정한 값이 참조 영역 내에서 몇 번째에 위치하는지 그 위치를 표시해 줍니다. 어떻게 보면 Vlookup(), Hlookup() 함수와 비슷한데 차이점은, Lookup() 관련함수들은 해당 값을 찾고자 할 때 사용을 하는 반면, Match() 함수는 해당 값의 위치를 받고 싶을 때 사용한다는 것입니다.
사용 형식은 Match(찾을 값, 찾을 영역, Match_Type) 이렇게 사용합니다. 여기서 매치 타입은 -1, 0, 1 이렇게 세 가지 중 한가지를 갖습니다.
-1: 작거나 같은 값 중에서 최대값 0: 같은 첫째 값 1: 크거나 같은 값 중에서 최소값을 찾습니다
참고: 위 Match_Type 설명은 1과 -1이 서로 바뀌어 있습니다. 실제로는 1(기본값)이 찾을 값보다 작거나 같은 값 중 최대값(오름차순 정렬 전제), 0이 첫 번째로 같은 값, -1이 크거나 같은 값 중 최소값(내림차순 정렬 전제)을 찾습니다. 이 글의 예제는 모두 0을 사용하므로 수식에는 영향이 없습니다.
이 요소를 생략하면 1이 기본값으로 설정됩니다. Match() 함수는 아주 재미있는 것이기 때문에 도움말을 꼭 살펴보시기 바랍니다.
수식을 분석해 보기 위해, 위의 수식에서 노란색 부분을 수식입력바에서 선택하고 <F9>키를 눌러 보세요.

여기서 1;2;2;4;4… 등의 숫자는 어떤 의미일까요? Match() 함수의 Match_Type이 0이면 영역 내에서 같은 첫째 값의 위치를 찾는다고 설명을 드렸습니다. 그러므로 각 숫자값이 최초로 등장한 위치값을 나타냅니다.
그 다음에 이것을 Frequency() 함수를 써서 그 빈도만을 추출하면 "7"이라는 값이 얻어지는 것이지요.
Case 3 공란이 포함된 혼합자료 중에서 중복되지 않는 항목의 개수 세기
{=SUM(IF(FREQUENCY(IF(LEN(영역4)>0,MATCH(영역4,영역4,0),""),IF(LEN(영역4)>0,MATCH(영역4,영역4,0),""))>0,1))}공식은 엄청 길고 복잡해 보입니다만 If() 함수와 Len() 함수를 추가해 준 것뿐이므로 차근차근 생각해 보시기 바랍니다. Match() 함수를 써서 위치값을 구하기 전에, 해당 셀이 공란이라면 이 셀을 작업 대상에서 제외시키기 위한 부분이 하나 추가되었습니다. 나머지는 Case 2와 거의 같습니다.
주의! 공식 좌우에 {}표시가 있지요? 따라서… 그렇습니다. 배열수식이지요. 따라서 공식을 다 입력하신 다음에는 Ctrl + Shift + Enter키를 탁 치시면 됩니다.
Case 4 가장 빈도수가 높은 문자열 찾기
{=INDEX(영역3,MATCH(MAX(COUNTIF(영역3,영역3)),COUNTIF(영역3,영역3),0))}이 수식도 Case 3과 마찬가지로 배열수식을 활용하였습니다. Index() 함수는 지정한 영역 내에서 지정한 위치에 해당하는 값을 돌려주는 함수입니다. 주로 Match() 함수와 한 쌍으로 많이 사용됩니다. Max() 함수는 짐작하시겠지만 지정한 영역 내의 최대값을 돌려주는 함수입니다.
따라서 이 두 가지 함수를 Countif() 함수와 적당히 조합하면 해당 영역 내에서 가장 빈번하게 등장하는 값의 위치를 구할 수가 있을 것입니다. 그러면 이것을 가지고 Index() 함수를 사용하여 해당 값을 구하면 되겠지요?
이 방법도 배열수식을 사용한 것이므로 수식입력 후에는 반드시 Ctrl + Shift + Enter 키로 마무리를 해 주셔야 합니다.
Case 5 가장 빈도수가 높은 문자열의 빈도수 Counting 하기
{=COUNTIF(영역2,INDEX(영역2,MATCH(MAX(COUNTIF(영역2,영역2)),COUNTIF(영역2,영역2),0)))}Case 4와 비슷한데 한 가지가 추가되었습니다. 즉 Index() 함수를 통해 돌려받은 값이 영역2에서 몇 번이나 사용되었는지 Countif() 함수를 써서 한번 더 작업해 준 것으로, 이 방법도 배열수식을 사용한 것입니다.
조금 복잡한 듯이 보입니다만 잘 활용하시면 유용하게 사용할 수 있는 것이니까 몸에 완전히 붙이도록 하세요.
그리고 간략하게 설명드린 Frequency(), Max(), Match(), Index() 함수 등은 반드시 도움말을 찾아보시기 바랍니다. 도움말에 보시면 많은 예제들이 있으니까 정리를 해 두시면 좋겠군요.
다음 시간에…
2000-10-11
정리 — 다양한 Counting 방법들
| 구분 | 내용 |
|---|---|
| Case 1 숫자 자료의 고유 항목 수 | =SUM(IF(FREQUENCY(영역1,영역1)>0,1)) (결과 9) |
| Case 2 문자열 자료의 고유 항목 수 | =SUM(IF(FREQUENCY(MATCH(영역2,영역2,0),MATCH(영역2,영역2,0))>0,1)) (결과 7) |
| Case 3 공란 포함 혼합자료의 고유 항목 수 (배열수식) | {=SUM(IF(FREQUENCY(IF(LEN(영역4)>0,MATCH(영역4,영역4,0),""),IF(LEN(영역4)>0,MATCH(영역4,영역4,0),""))>0,1))} |
| Case 4 가장 빈도수가 높은 문자열 (배열수식) | {=INDEX(영역3,MATCH(MAX(COUNTIF(영역3,영역3)),COUNTIF(영역3,영역3),0))} |
| Case 5 그 문자열의 빈도수 (배열수식) | {=COUNTIF(영역2,INDEX(영역2,MATCH(MAX(COUNTIF(영역2,영역2)),COUNTIF(영역2,영역2),0)))} |
자주 묻는 질문 (FAQ)
Q1. 숫자 자료에서 중복되지 않는 항목의 개수는 어떻게 세나요?
SUM, IF, FREQUENCY 함수를 조합해 FREQUENCY 결과가 0보다 큰 항목만 1로 세면 됩니다. 예제의 영역1에서는 9가 나옵니다.
Q2. 문자열 자료에서 중복되지 않는 항목의 개수는 어떻게 세나요?
MATCH 함수로 각 값이 처음 나타나는 위치를 구한 뒤 그 위치들을 FREQUENCY 함수로 세면 됩니다. 예제의 영역2에서는 7이 나옵니다.
Q3. 가장 자주 나오는 문자열과 그 횟수는 어떻게 구하나요?
INDEX, MATCH, MAX, COUNTIF 함수를 배열수식으로 조합합니다. 문자열은 Case 4의 수식으로 구하고 횟수는 Case 5처럼 COUNTIF를 한 번 더 사용하며, 입력 후에는 Ctrl+Shift+Enter로 마무리합니다.
마치며
배열수식으로 입력한 수식은 입력 후 반드시 Ctrl + Shift + Enter 키로 마무리하시기 바랍니다. VBA에 대한 기초 지식을 공부하실 분은 아이엑셀러 닷컴 사이트 상단 메뉴에서 [Excel 강의] - [Excel 입문]을 먼저 보시면 이해하기 쉽습니다.